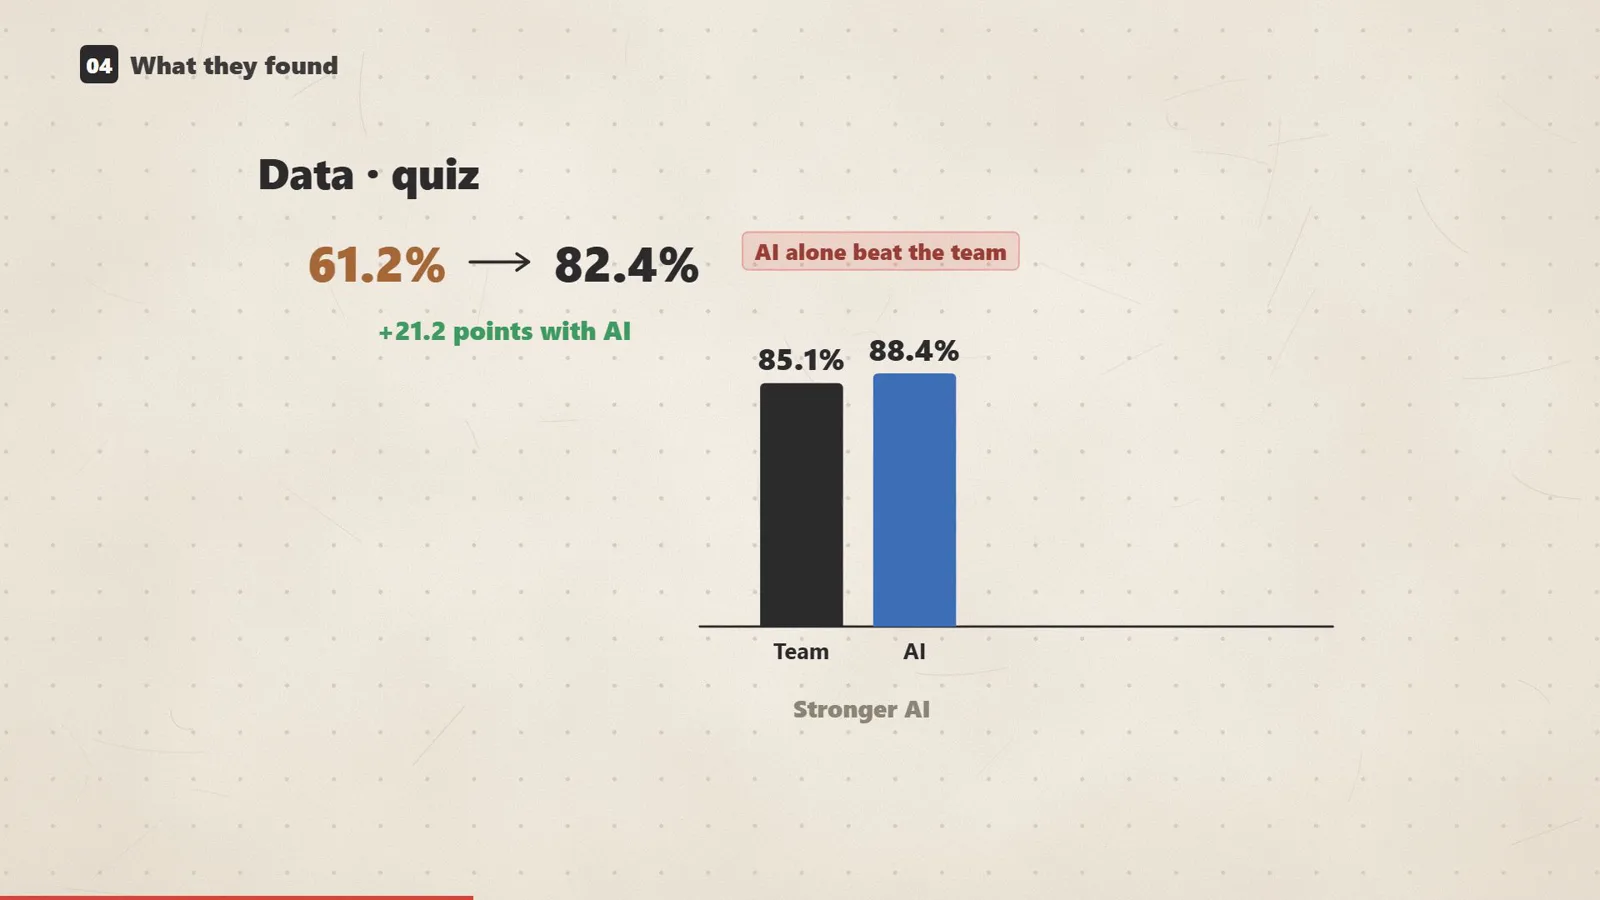
一项新研究让人们先自己答选择题,再在AI助手的帮助下答一次。用较强的AI(GPT-4o)时,人和AI一起答对了85.1%,AI单独答对了88.4%,人自己答只有60%。AI帮了大忙,团队却还是比不上AI单干。作者的解释里有一部分讲的是共同证据:你和AI看同一份材料时,它的同意像是第二个意见,但可能只是同一个意见被算了两次。
研究做了什么,发现了什么
论文是《AI辅助分类中的相关性忽视与信任》,作者Kong、Lyu、Amin、Bennouna、Huttenlocher、Ozdaglar,是来自麻省理工学院和西北大学的六位研究者(arXiv 2611.05870,2026年11月4日发布)。这是预印本,我们还没核实它的同行评审状态。第一部分是一个数学模型:人和AI各自掌握一些证据,其中一部分是共同的。第二部分重新分析了另一个团队早先的答题研究ChatBench:网上的众包答题者回答数学、物理和道德推理选择题,先自己答,再配一个AI(GPT-4o或较小的Llama)答。作者没有收集新数据,分析用了315人、389道题、2199组配对答案。这是答题测验,不是真实工作场景。
理论部分说,如果一个人把共同证据算了两次(研究里叫“相关性忽视”),“更强的AI可能让团队更不准确”;而清楚哪些是共同证据的细心人,至少和任何一方单干一样好。数据部分:两种AI合起来看,人自己答对61.2%,有AI帮忙后是82.4%,提高约21个百分点。用较小的AI时,团队79.5%,AI 78.7%,基本持平。AI单干的分数是多次作答的平均,不完全是每个人看到的答案。数据里最清楚的问题,方向正好相反:按作者估计,人给AI的分量只有细心的人应给的四分之一左右。一个更多听从较强AI的规则,在旧答案上能把团队从85.1%提高到87.7%,但这只是对过去答案的模拟。作者还提醒,这些数字未必适用于医学或用人决策。
证据有多扎实
- 准确:论文引用的实验室实验发现,很多人确实把相互关联的信息当成独立的,会“重复计算”。但那里的人看得到信息怎么关联;面对AI,重叠是看不见的。论文自己的数据不支持完全忽视重叠,也没能确定忽视了多少。
- 被拉伸:一项2024年汇总106个实验的综述,被说成“比人单干没有提升,甚至更差”。实际发现是:团队比两者中较强的一方差,但明显比人单干好。
- 写错两处:论文说ChatBench在亚马逊的众包平台上进行,原始研究其实在另一个平台招募;论文说同一批人搭配了不同的AI,实际每人只配一个,论文第30页自己也承认了。
- 缺失:与“人用AI太少”最相关的“算法厌恶”研究没有被引用。
结论:理论扎实,数据偏弱。可以引用它的想法,别引用它的数字。
我们的小实验
我们做了一个模拟,案例都是虚构的,测什么在运行前就写好了。人答对的概率是70%,AI是85%,AI也读过的人方证据比例从零调到全部。比较三种合并方法:只算一次共同证据的细心人、重复计算的人、重复计算再多问一个单独答对70%的新来源。每种重叠程度跑十轮,每轮二十万个案例。
没有重叠时,两种方法都答对87.7%,高于AI单干的85%。重叠到70%起,重复计算就不如直接听AI;完全重叠时只有83.6%,差1.4个百分点。它还变得过度自信:完全重叠时平均自称有将近88%的把握,多自信了约4个百分点,人和AI意见一致时多了5.5个百分点。加一个新来源后升到86.5%,但仍多自信约3个百分点。在这个设置里,只要AI比人强,重复计算就没有比人单干更差。这是对想法的检查,不是重做论文。
可以怎么用
当读同一份材料的AI同意你时,先问:它看到了什么、想到了什么我没想到的?如果没有新东西,就去找另一份来源:贷款申请之外的还款记录,简历之外的工作样本或背景调查电话,理赔照片之外的现场查看或维修发票。然后把每个来源写在决定旁边。这在核保、人才筛选、理赔、审计和质检这类以复核为主的工作里最要紧。办法不是简单地多信或少信AI,而是弄清每个来源到底看到了什么。