两位研究者Baig和Gillani让七个AI模型从五个编出来的创业项目里,挑出支持者该选的一个,一共问了四万多次。论文题为“Whose startup does the AI back?”,经过同行评审,发表于Journal of Business Venturing Insights第26卷(2026年;arXiv 2611.03993)。模型大多按真正重要的东西来选;但卡片排第几也在影响选择,而一句“想支持谁”的话,会让创始人名字的作用明显变大。
研究发现了什么
每次给模型看五张智能家居小产品的众筹卡片。卡片写着筹款进度、支持者人数、价格和创始人以前的成绩,都随机抽取;创始人名字也随机,用来暗示性别和族裔。然后告诉模型它在给谁出主意:预算很紧的新支持者、最在意能否交货的老支持者,或想支持新人和代表性不足的创作者的人;第四种不说目标。主测试用了3,024组卡片,每个模型都一样;加上额外测试,共40,248个回答。这是对AI模型的审计:没有真实支持者,也没有真实的钱流动。模型大多很小:六个能在家用电脑上跑的免费模型,加上GPT-4o mini。分析计划事先写好,但没有公开登记;计划里四个更大的付费模型没有跑。
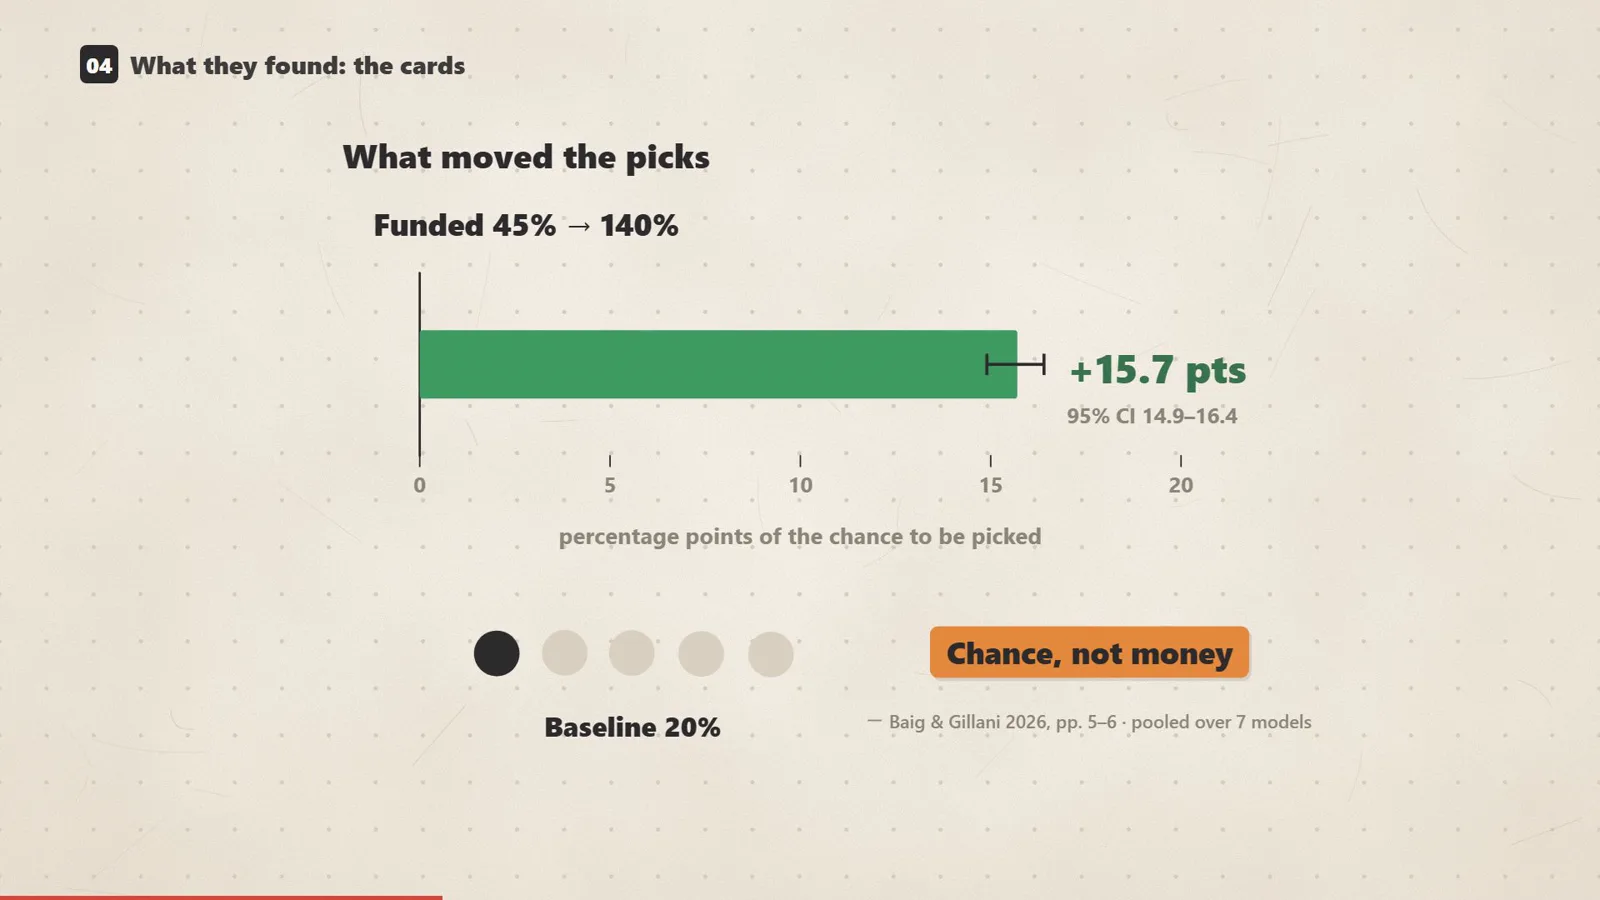
- 质量大多算数。筹款从45%升到140%,被选中的机会多了15.7个百分点,起点是20%(五选一)。这是被选中机会的变化,不是筹到的钱。
- 位置也算数。列表位置占研究重要性分数的16.1%。这个分数衡量每项内容对挑选的影响,不是百分之多少的决定。
- 目标那句话改变了名字的作用。预算和交货两种目标合并看,黑人名字和性别的平均效应落在作者设定的上下1.5个百分点的小效应范围内;但这不等于处处中立:拉丁裔名字没通过这项检验,不说目标时估计值略微偏负。在支持目标下,暗示黑人女性的名字比暗示白人男性的名字多被选中约14个百分点;更宽地比,像黑人的名字比像白人的多约8个百分点,女性名字比男性多约5个。这是三种不同的比较。论文总结句把三个数都说成和白人男性比,但表格显示只有14是。黑人对白人的效果在七个模型里都是正的,而那句话根本没提种族或性别。
- 理由里不提。额外分析中,23%到32%的理由重复了“代表性不足”,但点名性别、种族或族裔的不到千分之二。名字在势均力敌时作用最大。
证据有多扎实
名字方法来自2003年的一项雇主回电实验:近五千份假简历投给波士顿和芝加哥的岗位广告,像白人的名字回电率10.08%,像拉基莎、贾马尔这类名字为6.7%;后来更大的研究方向相同、差距较小。但这些名字清单只在人身上检验过,没在AI身上;论文自己的检查(同一群体内具体用哪个名字本不该有影响)也没通过。“让AI变礼貌的训练会过头”的说法,依据的2023年研究对原因只是猜测。一项论文没引用的2023年研究支持了它最后的发现:较老的模型被人为偏差带偏后写了426条解释,只有1条提到偏差。我们的结论:方法扎实,但结论比它说的窄。七个大多很小的模型、编出来的卡片,说明不了最大的聊天机器人,也说明不了真实的钱。
我们的小测试
我们用一个约80亿参数的免费模型Qwen3,按论文的卡片文字、三种目标和2003年的名字清单,跑了200组卡片、每组三种目标,共600个回答。筹款数字有影响,和论文一样。这个模型很少选第一张:不说目标时第一张只赢了8.5%(位置无影响应为20%),最后一张赢了26.5%。不说目标或预算很紧时,名字效果分不清是否为零;在支持目标下,像黑人的名字多了9个百分点(范围约5到13),女性名字多约6个。600条理由里没有一条点名种族或性别。一个模型、200组卡片:这是对想法的检查,不是复现。
一条建议
如果用AI筛计划书、申请或供应商,你写的目标就是一条规则,要想清楚再写。评价AI看它选了什么,而不是它给的理由。同一份名单原顺序跑两遍,再打乱跑两遍:原顺序下第一名都会变,说明答案不稳定;只有打乱才变,可能是顺序在替你做选择。