研究做了什麼,發現了什麼
這是一篇預印本論文,標題是《枯燥、骯髒、危險?》(Dull, Dirty, Dangerous?),作者是普渡大學丹尼爾斯商學院的 Siyi Yu,2026年11月4日發佈於 arXiv(2611.06888)。我們還沒核實它的同行評審狀態。它是一項觀察性研究:用已有的公開數據,在不同職業之間找規律,沒有新增訪談或實地觀察。作者説得很直白:這兩個指標都沒有觀察到AI的實際部署或者失業。
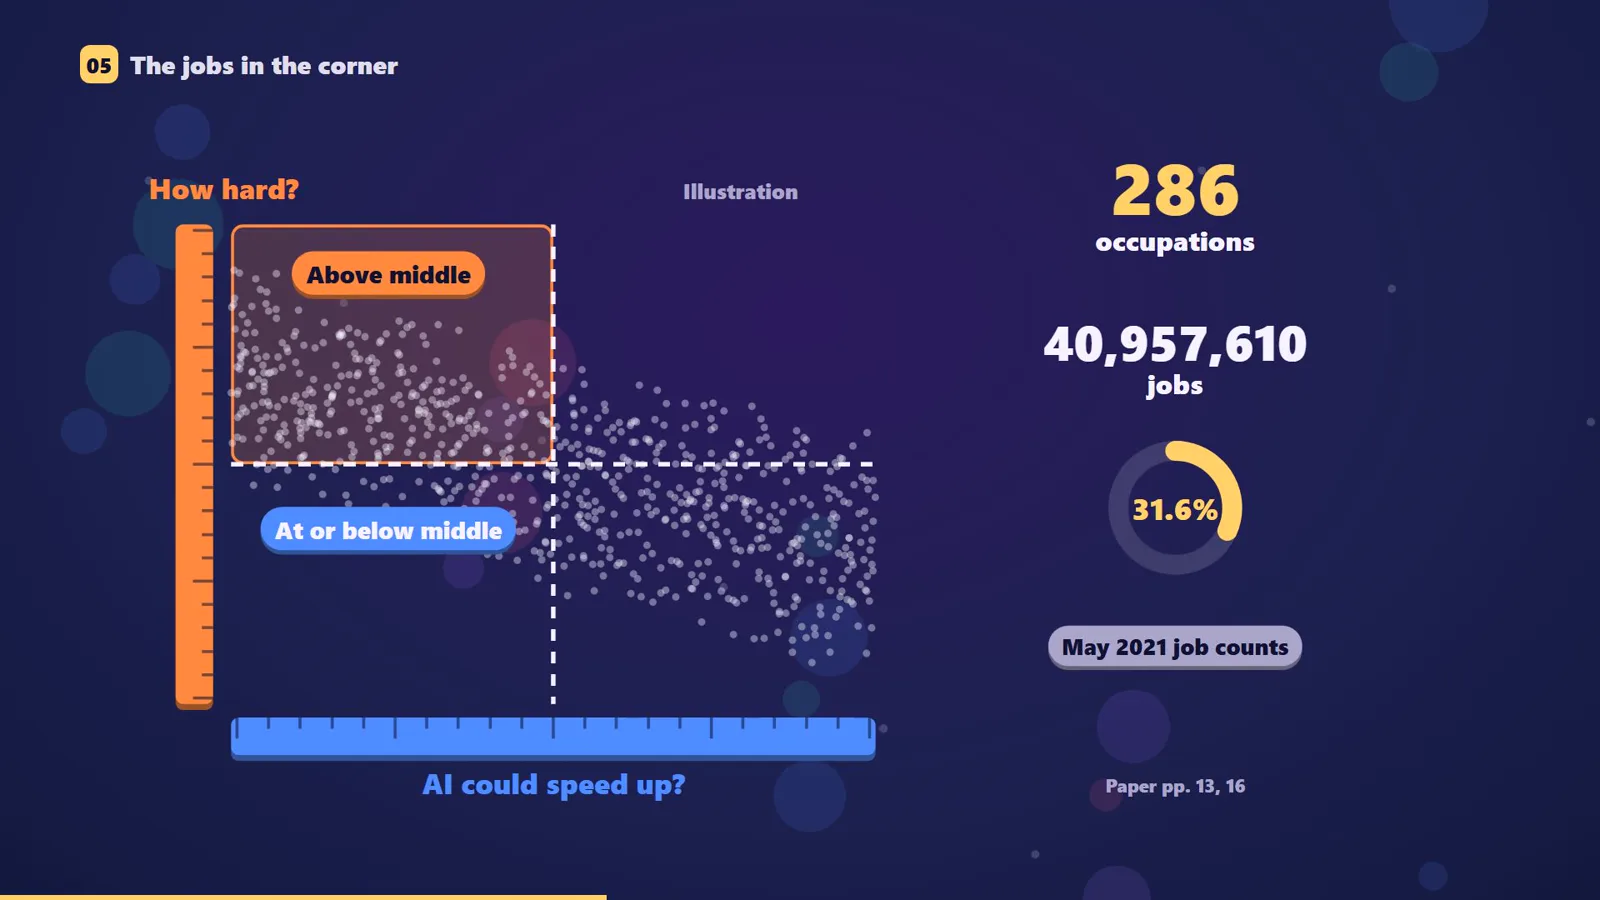
可以想象兩把尺子。第一把量工作條件有多辛苦,用的是美國政府職業數據庫 O*NET 第31.0版裏的21項評分,分成危險、骯髒、枯燥三組。第二把量AI語言模型能幫這份工作提速多少,用的是兩套已發表的評分:Eloundou 等人請人和GPT-4給任務打的分,以及 Felten 等人2021年的一套更早的評分。“暴露度”只是對潛力的評分,不代表已經在用。研究覆蓋754種職業,佔美國政府2021年5月就業統計裏92%的工作。
規律是:AI尺子上越高的工作,辛苦尺子上往往越低,每高一格,大約低三分之一格。但把每份工作有多耗體力考慮進去以後,關聯明顯減弱(從負0.343降到負0.093)。在最完整的模型裏,再加上學歷、上崗準備和工資,語言模型評分的可能取值範圍包含零;更早那套評分仍在零以下。AI暴露度對職業差別的額外解釋只佔很小一點(1.1%和2.4%)。作者強調,這只是描述規律,不説明因果。
辛苦、兩套AI評分又都不高的這個角落,有286種職業、將近四千一百萬個工作崗位,佔研究全部工作的31.6%,包括建築工人、重型卡車司機、護理助理、餐館廚師、園林工人和客房清潔工。這個數字數的是2021年5月數據裏的崗位,不是想要幫助的人數,也不是面臨風險的人數。而且辛苦各不相同:建築工人自己的三項得分裏“骯髒”最高(2.07),客房清潔工則是“枯燥”最高(1.18)。
證據有多硬
我們通讀了論文,並順着引用追到原始數據。研究對來源的描述是準確的。主要的AI評分規定:語言模型能把任務時間縮短至少一半、質量不變,才算“暴露”;評分者還被告知模型沒有任何實物工具或材料。那項研究自己也説,至少目前體力勞動不會暴露於語言模型。所以體力活在這把尺子上得分低,有一部分是尺子本身決定的。
- 兩套AI評分用的是同一個職業數據庫,相關高達0.833,不是兩個互相獨立的證人。
- 更早那套評分,我們只能打開主要論文的摘要,打不開下面的眾包調查。
- “枯燥、骯髒、危險”這句口號,我們沒能追溯到任何針對工人的研究。研究引用的一篇2026年機器人綜述發現,用這句話的論文裏只有25篇(2.7%)給了正式定義。
- “枯燥”指對重複和自主程度的評分,不是無聊的感覺。“自己説了不算”和AI評分的關聯比“重複”強得多,但這個差別沒有做正式檢驗。
我們的結論:紮實,但在意料之中。
我們的小實驗
我們下載了 O*NET 31.0(2026年8月)和已公開的暴露度評分,運行前先寫下要測什麼、預期什麼(這是我們自己的記錄,不是外部登記),用21項評分裏的9項做了一個更簡單的辛苦指標。在772種職業上,關聯是負0.70;在同一職業大類裏比較是負0.36,研究是負0.343。加入體力因素後,我們的降到負0.15,少了一半以上,與預期一致,但沒有像研究的負0.093那樣接近零。我們的指標更簡單,也沒加學歷和工資,兩者不能直接比較。第一次運行時代碼在出數字前就崩了,已經修好。
數據科學家在AI尺子上高於95%的職業,在辛苦尺子上只高於9%;軟件開發人員是98和5;建築工人正好相反,辛苦94、AI 12。我們的角落裏,772種職業中有305種(39.5%)辛苦又低暴露,但這數的是職業種類,不是人數,和31.6%不是同一種數字。
可以怎麼用
語言模型分數低,不是護身符。在我們的一個項目裏,倉庫裝卸區上方的攝像頭把每一步和標準流程對照,對不上就打時間戳;只看動作、不認人,沒有人臉識別。手工搬運工在AI尺子上接近零,AI還是來到了他們的工作裏。研究也提醒:分數低不能説明不受別的自動化或管理工人的軟件影響。
有人推薦“讓工作更安全的AI”時,先問三個問題:它改變哪項任務?哪種條件會變好,搬重物、噪音還是節奏?工作又流向哪裏?再和調整人手、換更安全的設備這類樸素辦法比一比。對自己的工作,可以寫下十項主要任務,逐一標記:語言模型能提速嗎?是體力活嗎?是不是風險高、出不得錯?