兩位研究者Baig和Gillani讓七個AI模型從五個編出來的創業項目裏,挑出支持者該選的一個,一共問了四萬多次。論文題為“Whose startup does the AI back?”,經過同行評審,發表於Journal of Business Venturing Insights第26卷(2026年;arXiv 2611.03993)。模型大多按真正重要的東西來選;但卡片排第幾也在影響選擇,而一句“想支持誰”的話,會讓創始人名字的作用明顯變大。
研究發現了什麼
每次給模型看五張智能家居小產品的眾籌卡片。卡片寫着籌款進度、支持者人數、價格和創始人以前的成績,都隨機抽取;創始人名字也隨機,用來暗示性別和族裔。然後告訴模型它在給誰出主意:預算很緊的新支持者、最在意能否交貨的老支持者,或想支持新人和代表性不足的創作者的人;第四種不説目標。主測試用了3,024組卡片,每個模型都一樣;加上額外測試,共40,248個回答。這是對AI模型的審計:沒有真實支持者,也沒有真實的錢流動。模型大多很小:六個能在家用電腦上跑的免費模型,加上GPT-4o mini。分析計劃事先寫好,但沒有公開登記;計劃裏四個更大的付費模型沒有跑。
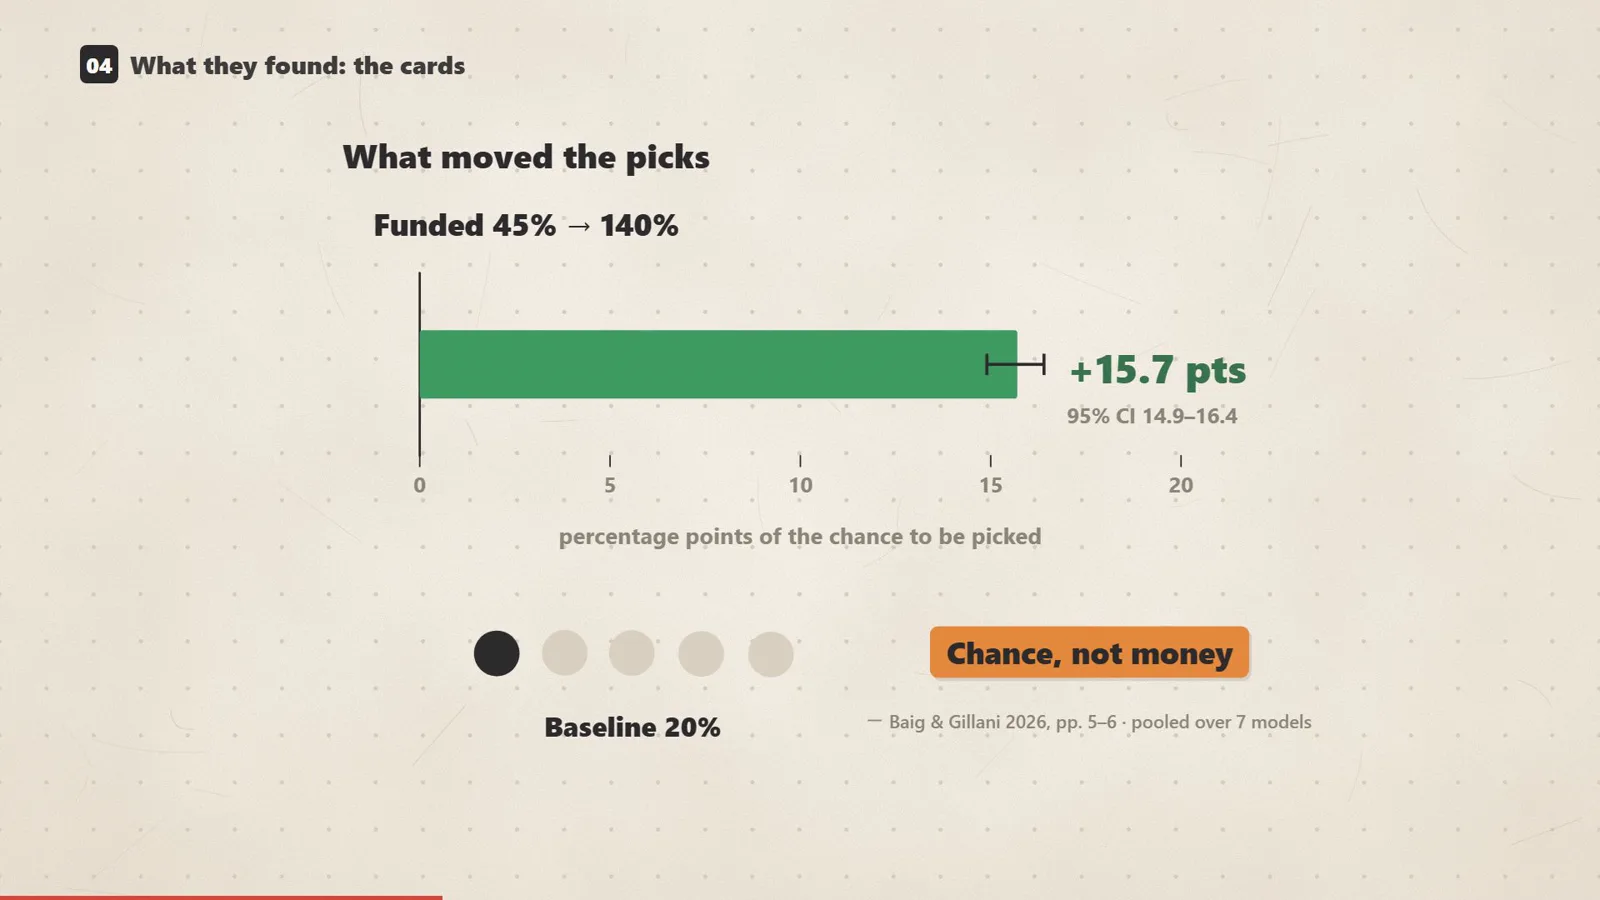
- 質量大多算數。籌款從45%升到140%,被選中的機會多了15.7個百分點,起點是20%(五選一)。這是被選中機會的變化,不是籌到的錢。
- 位置也算數。列表位置佔研究重要性分數的16.1%。這個分數衡量每項內容對挑選的影響,不是百分之多少的決定。
- 目標那句話改變了名字的作用。預算和交貨兩種目標合併看,黑人名字和性別的平均效應落在作者設定的上下1.5個百分點的小效應範圍內;但這不等於處處中立:拉丁裔名字沒通過這項檢驗,不説目標時估計值略微偏負。在支持目標下,暗示黑人女性的名字比暗示白人男性的名字多被選中約14個百分點;更寬地比,像黑人的名字比像白人的多約8個百分點,女性名字比男性多約5個。這是三種不同的比較。論文總結句把三個數都説成和白人男性比,但表格顯示只有14是。黑人對白人的效果在七個模型裏都是正的,而那句話根本沒提種族或性別。
- 理由裏不提。額外分析中,23%到32%的理由重複了“代表性不足”,但點名性別、種族或族裔的不到千分之二。名字在勢均力敵時作用最大。
證據有多紮實
名字方法來自2003年的一項僱主回電實驗:近五千份假簡歷投給波士頓和芝加哥的崗位廣告,像白人的名字回電率10.08%,像拉基莎、賈馬爾這類名字為6.7%;後來更大的研究方向相同、差距較小。但這些名字清單隻在人身上檢驗過,沒在AI身上;論文自己的檢查(同一羣體內具體用哪個名字本不該有影響)也沒通過。“讓AI變禮貌的訓練會過頭”的説法,依據的2023年研究對原因只是猜測。一項論文沒引用的2023年研究支持了它最後的發現:較老的模型被人為偏差帶偏後寫了426條解釋,只有1條提到偏差。我們的結論:方法紮實,但結論比它説的窄。七個大多很小的模型、編出來的卡片,説明不了最大的聊天機器人,也説明不了真實的錢。
我們的小測試
我們用一個約80億參數的免費模型Qwen3,按論文的卡片文字、三種目標和2003年的名字清單,跑了200組卡片、每組三種目標,共600個回答。籌款數字有影響,和論文一樣。這個模型很少選第一張:不説目標時第一張只贏了8.5%(位置無影響應為20%),最後一張贏了26.5%。不説目標或預算很緊時,名字效果分不清是否為零;在支持目標下,像黑人的名字多了9個百分點(範圍約5到13),女性名字多約6個。600條理由裏沒有一條點名種族或性別。一個模型、200組卡片:這是對想法的檢查,不是復現。
一條建議
如果用AI篩計劃書、申請或供應商,你寫的目標就是一條規則,要想清楚再寫。評價AI看它選了什麼,而不是它給的理由。同一份名單原順序跑兩遍,再打亂跑兩遍:原順序下第一名都會變,説明答案不穩定;只有打亂才變,可能是順序在替你做選擇。