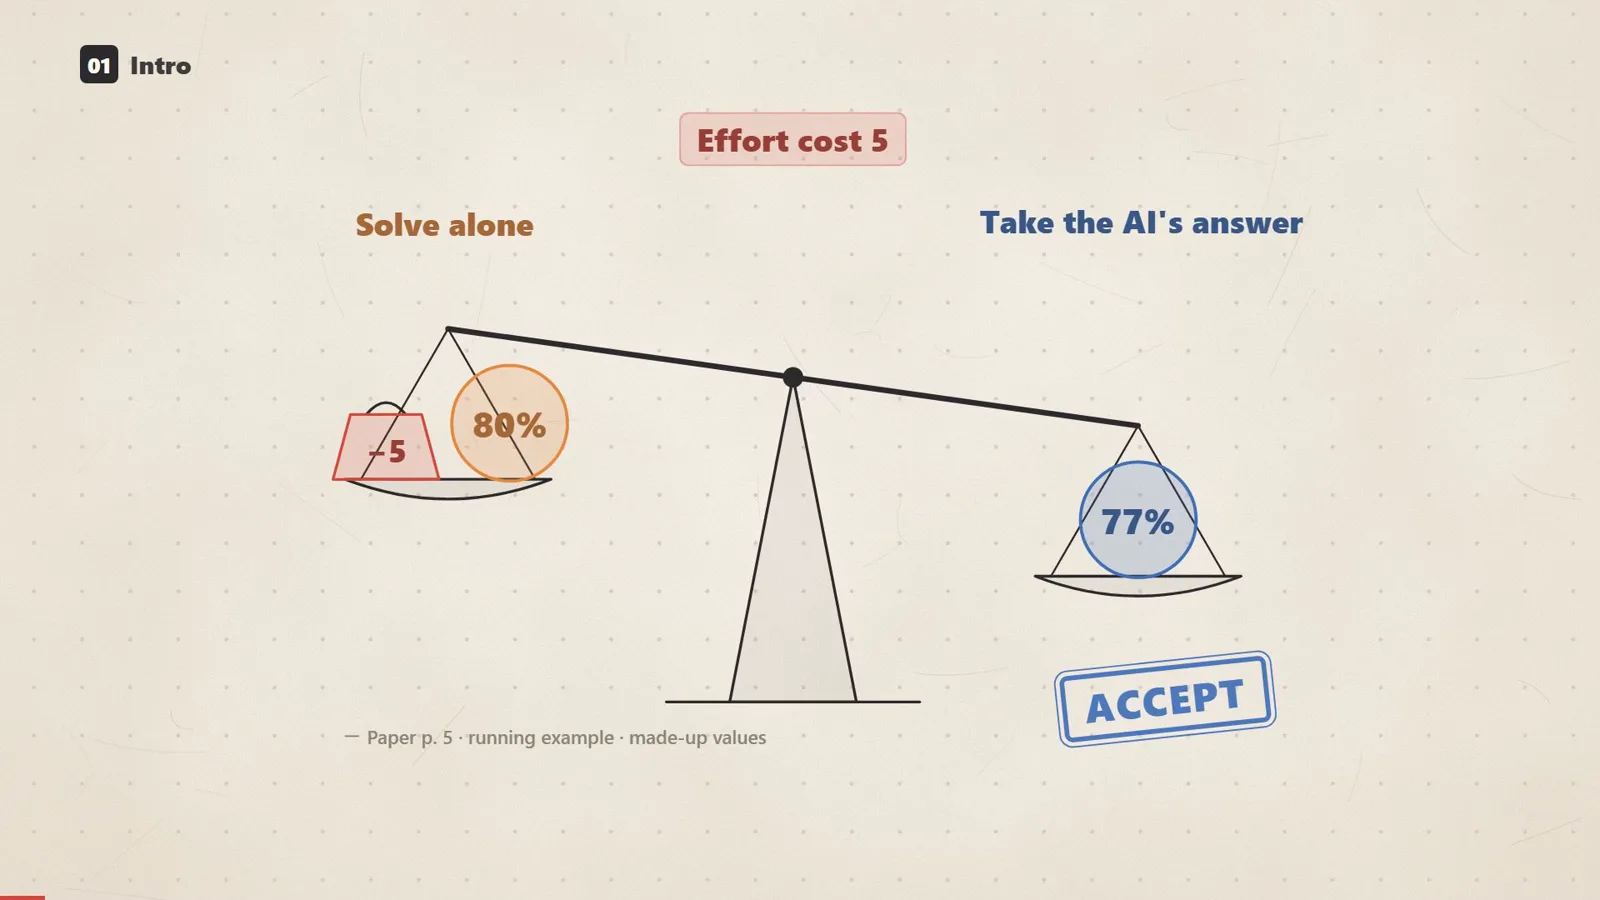
一項新研究提了一個很實在的問題:用了AI,你會不會少了練習?論文開頭舉了一個例子:一位專家負責檢查代碼裏的錯誤,她自己檢查能找到八成,她的AI助手能找到百分之七十七。她比AI略強,但自己檢查要花力氣,把這份代價算進去,每一次都是直接用AI的答案更划算。於是她一次又一次地接受AI的答案。結果一直是百分之七十七,看起來不錯,可她不靠AI時的本事在慢慢退化,從結果裏誰也看不出來。這些數字是編的,來自論文自己的例子;這是模型,不是對真實員工的測量。
這項研究是什麼,得出了什麼
論文題為 Today's Work, Tomorrow's Workforce: Incentivizing Learning in AI-Assisted Work,作者是 Diener、Hendriks、Spitzer、Satzger、Holstein(德國卡爾斯魯厄理工學院)和 Sun(IBM Research),2026年11月4日發佈在 arXiv(2611.06346)。這是預印本,我們還沒核實它的同行評審狀態。它是一個數學模型:一個員工,一長串類似的任務,引用了兩項早先的研究。每個任務,員工要麼接受AI的答案,要麼自己解;自己解要花力氣,但本事可能漲一級,接受能省力氣,但本事可能掉一級。作者自己説,例子裏用的是示意數值,“不是實證估計”。
論文區分了“產出準確率”(在AI幫助下的結果)和“獨立準確率”(自己做有多大比例做對),並指出大多數相關研究測的是前者。在模型裏:
- 如果練習現在和將來的好處抵不過它花的力氣,練習就可能停下來,哪怕這個人還比AI略準。
- 面對百分之六十二的AI,一個百分之四十的新手會一直接受,卡在最低一級,這叫“低技能陷阱”;專家則可能退化,叫“專家技能退化”。產出始終停在AI的水平。
- 一種只比今天任務準確率的常見打分方式,會説那個被卡住的新手對AI的依賴是恰當的。
- 給不靠AI做對的答案付錢,能讓人重新開始練習。作者也説明,他們的例子説明不了這在真實工作裏有多常見。
證據有多紮實
我們把論文的主要來源追查到了原處。“練習長本事”這條根很紮實:一項彙總86項研究的綜述發現,人對自己想出來的東西記得更牢,但那是實驗室和課堂裏幾分鐘到一週的記憶,不是幾個月裏的工作本事。本事不練會退,1998年一項彙總53項研究的綜述發現了這一點;但我們找到的來源裏,沒有一項測過每接受一次AI答案本事會掉多少,這部分是模型的假設。現實證據有兩項:一項是52個程序員一小時的小試驗,用AI的一組在滿分27分的測驗裏,平均比不用AI的一組低4.15分,論文描述準確,但規模小,而且是預印本;另一項是波蘭四家診所的醫生,不用AI的檢查發現率從28.4%降到22.4%,論文説這是AI撤掉之後發生的,其實並沒有撤掉,而且這是觀察性研究,所以這條根被拉伸了。論文還漏提了部分同一批作者早先的一項實驗:180人蔘與,給不靠AI答對的答案發固定獎金,結果被鑽了空子,準確率略降(63.2%,沒有獎金的組是64.3%),有針對性的獎金則略升到65.3%。結論:想法説得通,證據偏薄。
我們做的小實驗
我們用代碼重建了論文的模型,用的是論文例子裏的數字:新手百分之四十、中級員工六十、專家八十,各做三百個任務,AI為百分之七十七。這是模擬,員工和概率都是編的;我們核對的七個數字與論文全部吻合。按論文的規則,三個人每次都接受AI,結果停在百分之七十七,但專家不靠AI的預期本事降到五十三左右,中級員工降到四十二左右,百分之九十五的模擬專家至少掉了一級。改成每隔一個任務由人先答(交出去的仍是AI的答案),結果仍是百分之七十七,新手漲到五十九左右,中級員工漲到六十九左右。意外的是,專家最後仍在七十四左右,百分之四十的模擬專家還是掉了一級;代價是多出一百五十次嘗試。一次小測試的噪聲也很大:若本事真從八十降到七十,二十題的測試約有百分之二十九的情況看不出下降。這是對想法的檢查,不能證實這篇論文。
一條實用建議
把它當作設計原則,而不是測出來的事實。挑一個你每天交給AI的任務,其中一部分先自己做,再看AI的答案;每個月用過去的案例做一次不用AI的小盲測,記下分數,看幾個月的趨勢,別隻看一次。管理者可以在產出準確率旁邊同時跟蹤獨立準確率;如果要獎勵練習,要設計得小心。這些是值得試的做法,不是已被證明有效的辦法。