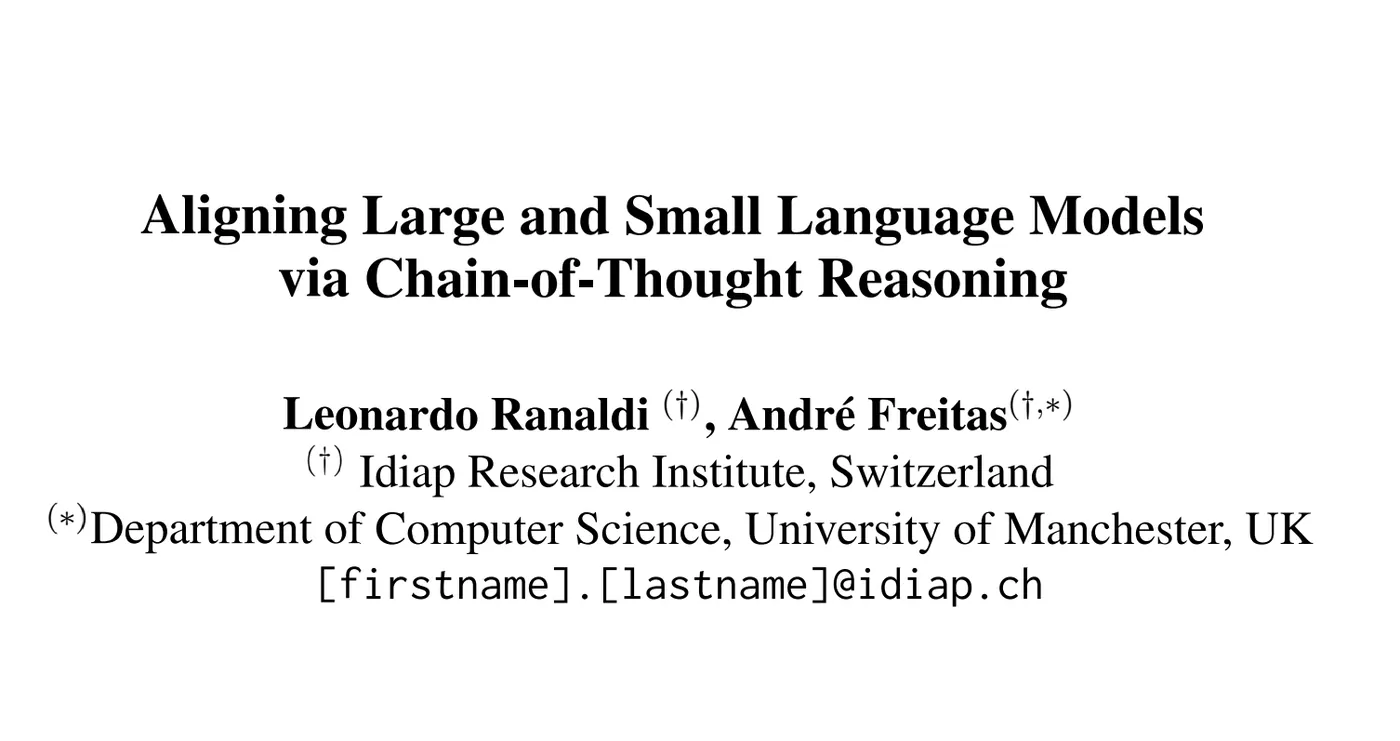
鏈式思維(CoT)提示增強了大型語言模型(LLM)的推理能力,使其能夠逐步解決複雜問題。
挑戰:這些能力僅出現在擁有數十億參數的模型中,這對使用小型語言模型(SLM)的用户構成了障礙。
解決方案:本文提出一種基於CoT示範的指令微調-CoT方法:
- 將大型LLM的推理能力遷移至小型SLM
- 使SLM能夠在CoT機制下生成多步驟、可控的推理答案
- 利用強大模型的輸出指導小模型學習
實驗結果:在問答和數學推理基準上,採用該方法訓練的SLM在域內與域外場景均顯著優於基線。
參考資料:ACL 論文
鏈式思維(CoT)提示增強了大型語言模型(LLM)的推理能力,使其能夠逐步解決複雜問題。
挑戰:這些能力僅出現在擁有數十億參數的模型中,這對使用小型語言模型(SLM)的用户構成了障礙。
解決方案:本文提出一種基於CoT示範的指令微調-CoT方法:
實驗結果:在問答和數學推理基準上,採用該方法訓練的SLM在域內與域外場景均顯著優於基線。
參考資料:ACL 論文
本文由 Volckano 首發於 volckano.com。© Verve Group Inc.。轉載或引用請註明來源並鏈接本頁。 https://volckano.com/zh-hant/media/aligning-large-small-language-models-cot
告訴我們要解決的事,我們先判斷值不值得做。